
Webカメラ1台で3D配信をもっと手軽に。「ゆめかいろプロダクション」が独自開発した3D配信システムの裏側
こんにちは。VTuber事務所「ゆめかいろプロダクション」で3Dデザイナーを担当している田中です。
「ゆめかいろプロダクション」では、所属タレントが3Dモデルを自宅の配信環境でも気軽に活用できるよう、3D配信アプリを自社開発しました。2026年9月より、ゆめかいろプロダクションのタレントも実際に3Dアプリを利用した生配信を開始ししています。
本記事では、なぜ既存のアプリではなく自社開発を選んだのか。そして、Webカメラ1台で3Dモデルを動かすためにどのような工夫をしているのか。
実際の機能や開発時の試行錯誤も交えながら、「ゆめかいろプロダクション」の3D配信システムの裏側をご紹介します。
なぜ3D配信アプリを自社開発したのか
世の中には、すでに3Dモデルを動かすアプリケーションが多数存在します。
それにもかかわらず、なぜわざわざ内製を選んだのかというと...
理由は、最新の手法や表現をどんどん取り入れ、視聴者の皆さんに楽しさを提供し続けるためです。
3Dモデルを使用できるオールインワンの素晴らしい配信アプリは数多くあります。一方、それらを使用した場合、見栄えの制御や欲しい機能の追加を自分たちの意思決定だけで行うことは難しく、アプリ側の仕様に制限されてしまうことがあります。また、法人での利用ができないケースもあります。
そうすると、配信の都合でピンポイントに欲しい機能が出てきたり、タレントから要望があったりした際、すぐに対応することが難しくなります。
その点、自社開発のアプリであれば、自分たちで自由に機能を追加できます。迅速に必要な修正や実装を行い、次の配信ですぐに新機能を使うといったことも可能です。
配信技術にも流行がありますので、それらにアンテナを張り、素早く取り入れられることは、内製ならではのアドバンテージだと考え開発に至りました。
Webカメラ1台で3Dモデルを動かせる
今回開発したのは、Webカメラ1台だけでVTuberキャラクターを動かして配信できるUnity製のツールです。
さらに、そこにAI VTuberを動かすための仕組みを組み込んでいます。
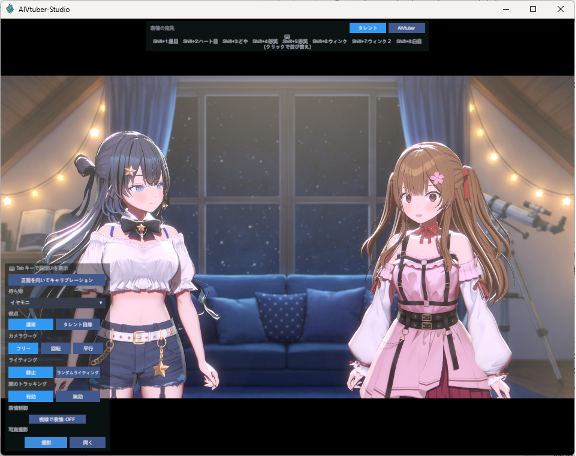
3つの運用モード
アプリには、大きく3つの運用モードがあります。
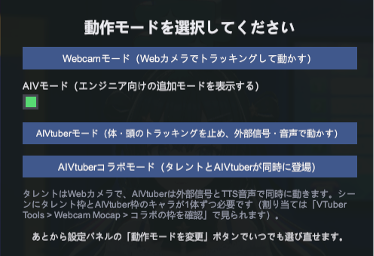
- Webcamモード
タレント本人の動きをWebカメラでトラッキングし、3Dモデルを動かします。 - AI VTuberモード
外部から送られるEmotion信号とTTS音声をもとに、AI VTuberを動かします。 - コラボモード
タレントとAI VTuberが同じ空間で共演できます。
つまり、同じアプリの中で「人間が演じる」「AIが演じる」「2体で共演する」を切り替えることができます。
誰でも使えるように。簡単なキャリブレーション
3Dモデルを正しく動かすために、最初にキャリブレーションという作業を行います。
VTuberの3D配信システムにおけるキャリブレーションとは、「生身の人間の体の動き」と「3Dモデルの動き」を一致させるための初期位置合わせ作業のことです。
誰でも簡単に設定できるよう、設定手順はUI上で案内されるようにしています。
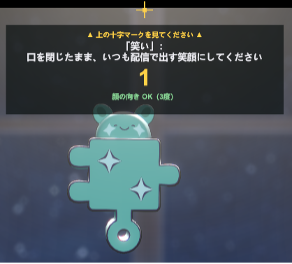
まずWebカメラの前に座り、自然体の姿勢を記憶させます。これは1クリックで完了します。
続いて表情のキャリブレーションです。Webカメラに映った喜怒哀楽の表情や「あ・い・う・え・お」の発声、口の開き方などを数値に変換し、アプリケーションに覚えさせます。
ゲームプレイ中も自動で変わる表情
キャリブレーションした情報をもとに、キャラクターモデルを動かします。
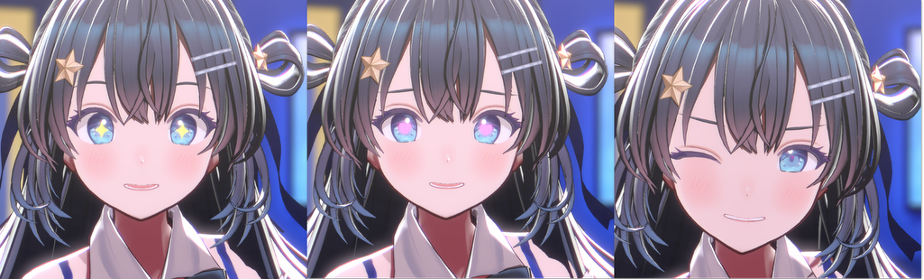
リップシンクや喜怒哀楽の表情は、通常時の顔との差分や音声解析によって自動的に切り替わります。
これによって、ゲーム配信などで手がふさがっている状態でも、自動的に表情を変化させることができます。
もちろん、ショートカットキーによる表情操作も可能です。また、表情切り替えのUIを視線で操作することもできます。
「3Dだからこそ」の自然な身体の動きをつくる
配信を行うタレントが、Live2Dなど普段使い慣れているアプリケーションとの挙動の違いを感じにくいよう、Live2Dと同じく、自身の頭の動きをベースに全身が動く仕組みを採用しました。
ただ、それだけでは動きがシンプルになりすぎてしまい、3Dであることの利点が失われてしまいます。
そこで、頭の動きに連動して、
重心移動、足の運び、呼吸による胸の上下、自然な腕の振り、カメラに近寄る動き、視線の制御
など、さまざまなアニメーションが自動的に動くようにしました。
より生き生きとしたキャラクターを演じられるよう、細かな部分まで工夫しています。
※体の動きの様子
また、目線ひとつをとっても、動きを徹底的に研究しています。
頭部の角度やカメラとの距離に応じて、「ここまではカメラを見続ける」「ここから先は目線を逸らす」といった制御を入れています。
目を伏せたり見開いたりする動きも加え、常に視線がとどまり続けることがないようにしています。
※目線の動きの様子
背景もカメラも自動で動く
背景には、2Dの背景画像や動画ファイルを読み込むことができます。
読み込んだ背景は、カメラと被写体の距離や角度に応じて自動的に立体感のある動きをします。特に、キャラクターに近寄った際、自動的に背景へブラーをかける「疑似被写界深度」の機能は効果的です。
背景画像には、ライティングの設定データを埋め込むこともできます。
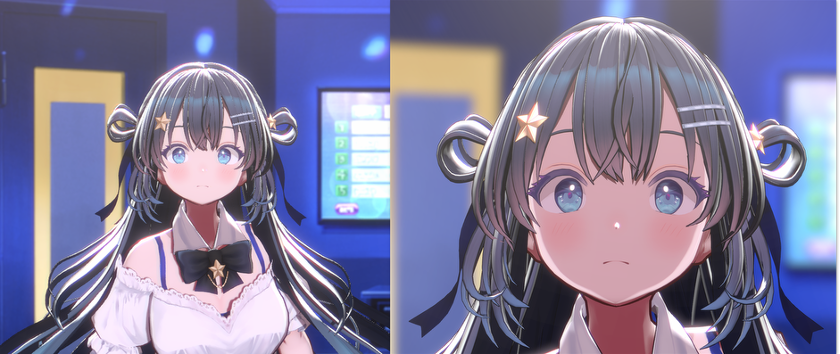
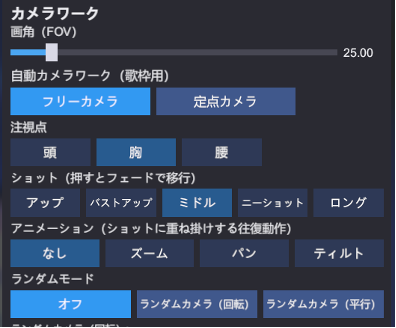
カメラについても、マウスによる移動・回転・ズームだけでなく、全自動カメラワークに対応しています。
クローズショット、バストショット、ニーショット、ロングショットなどの被写体との距離と、ズーム、パン、ティルトといったカメラワークをランダムに組み合わせられます。
さらに音声検知にも対応しており、AIVTuberとタレントの2人でのコラボでは話している方を自動的にクローズアップします。
歌配信を盛り上げるライティング
ライティングも細かく調整できます。
マウス操作によって、メインライト、リムライト、間接光それぞれの明るさや色味を変更できます。
さらにカメラワークと同じように、リムライトやディレクショナルライト、カラーを一定周期で自動的に動かすこともできます。
歌枠などで使用することで、配信の見栄えをより華やかにすることができます。
※カメラワークやライティングの様子
マイクやゲームコントローラーなどの「持ち物」にも対応
3Dのマイクやゲームコントローラー、ハンドルなどを手に持たせたり、頭にアイテムを付けたりすることもできます。
単に装着するだけではなく、自身の動きに応じてハンドルを回すといったアニメーションも付いています。
2D画像の読み込みにも対応しているため、イラストを手に持たせたり、ポリゴン化してメガネのイラストを立体的に顔へ貼り付けたりすることも可能です。
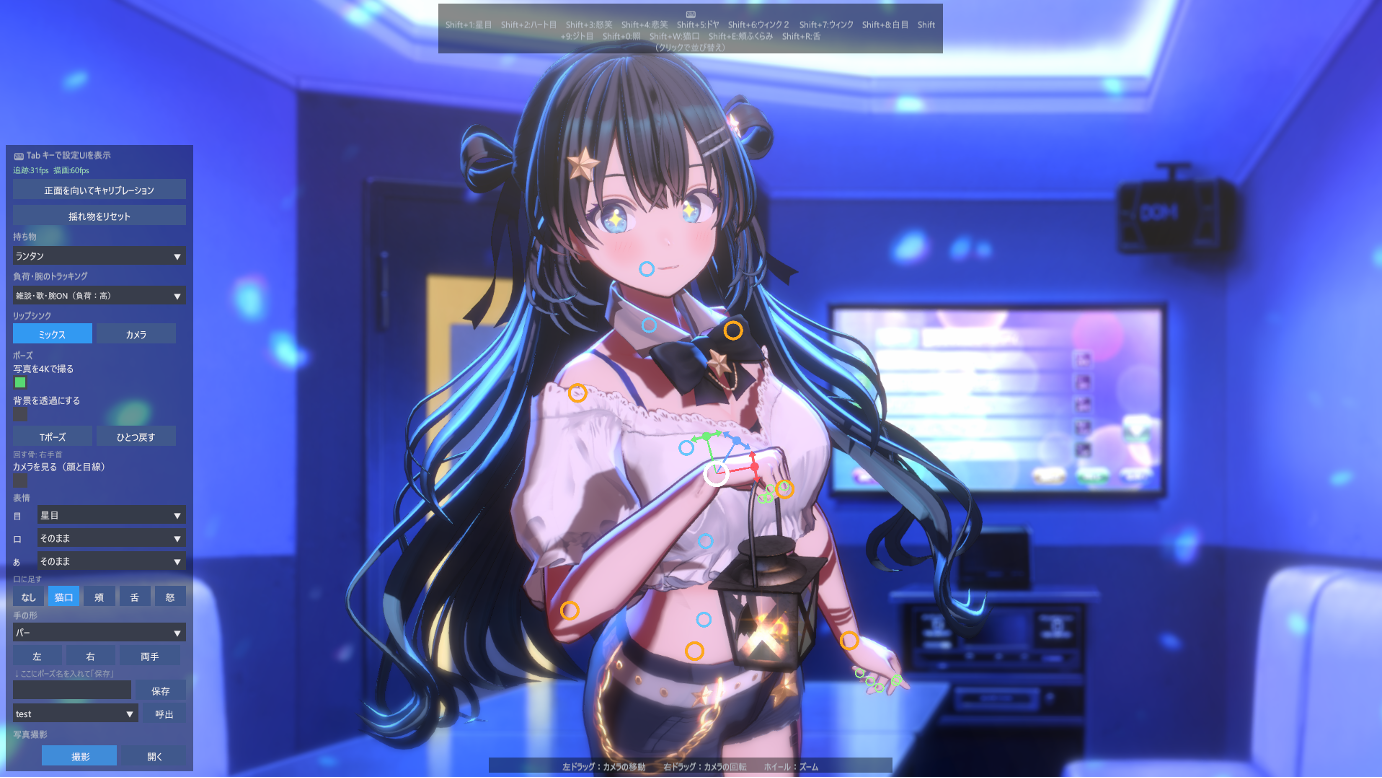
最大4Kでの出力やモーション録画にも対応
Spoutを使ってOBSへ直接送出できます。
ウィンドウサイズに左右されない固定解像度、最大4Kで送られるため、高解像度な配信画面を構築できます。
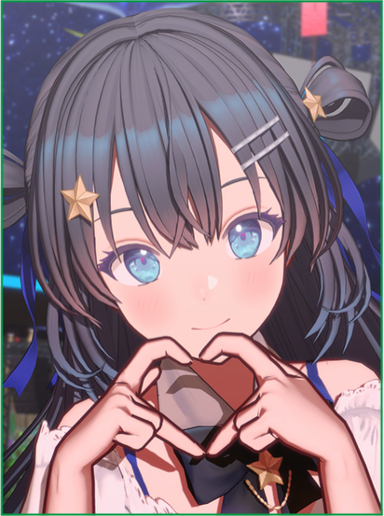
写真撮影機能にも対応しており、自分でポーズを取ったり、専用のピッカーを動かしてポーズを取らせて透過画像を書き出すこともできます。
さらにHumanoidモーション録画機能もあり、自分で演じた動きをモーションデータとして保存し、AI側のモーションとして利用することも可能です。
タレント自身で衣装を着せ替えられる未来も
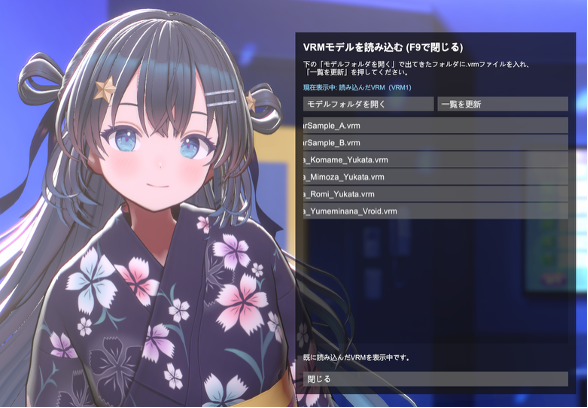
VRoidで書き出したVRM1.0モデルの読み込みに対応しています。
読み込むとシェーダーの統一、マテリアル調整、表情変換、モーションキャプチャーの配線まで自動で行われます。VRMモデル内に存在しないブレンドシェイプも顔の動きに関わる部分は自動的に生成されます。
直近ではVRoidの浴衣衣装を着たVRMデータでの衣装着せ替えを行っています。
将来的には、タレント自身で衣装を着せ替え、アプリに読み込んでそのまま配信するといった運用も想定しています。
配信だからこそ必要な「安全装置」
実際の配信で使うツールだからこそ、安全面にも配慮しています。
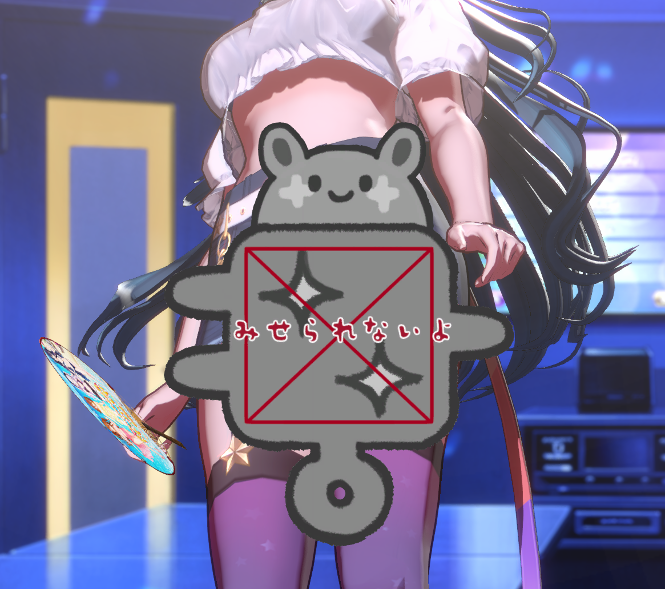
例えば、カメラアングルを変更してスカートの中が見えてしまうような角度になると、画像がスカートの内側に表示され、覗き見を防ぐ仕組みを実装しています。
また、タレントが離席すると「離席中」であることが分かる通知が自動的に表示されます。
ここまでご紹介した機能は全体のほんの一部で、ほかにも歌っている最中に自動でウィンクする機能など、実際の配信を重ねながら細かなアップデートを続けています。
Webカメラ1台だからこその課題
ここからは、技術的な面をさらに深堀していきます。
Webカメラによるトラッキングには、大きな課題があります。
映像をベースにしているため、タレントの自宅環境(部屋の明るさ、髪型、メガネ、アクセサリー、ゲーミングチェア、カーテン、ヘッドフォン、マイクなど)によって、トラッキング結果が大きく変わってしまいます。
物の色や形を人間と誤認することもあり、アプリ側だけで完全に解決するのは非常に難しい問題です。
現時点では、
- 静止物の手誤検出フィルター
- 手を短時間見失った際に腕を下ろさない処理
- 手姿勢の短時間保持
などの工夫をしています。
それでも誤認が起きる場合には、1ボタンで腕のトラッキングを無効化し、頭だけのトラッキングに切り替えられるようにしています。
腕をトラッキングしない分、処理も軽くなるため、ゲーム配信などではむしろ都合が良い場合もあります。
MediaPipeをそのまま使うだけでは、うまく動かなかった
トラッキングには、Googleがオープンソースで提供している「MediaPipe(メディアパイプ)」という、カメラ入力からのリアルタイムな画像処理・推論に特化したフレームワークを活用しています。
しかし、MediaPipeで普通のWebカメラ1台からランドマークを取得すると非常に不安定で、そのままではまともなトラッキングになりませんでした。
手や指の位置が毎フレーム小刻みに震え、ときどき大きく飛ぶ。指が重なると、手のひらの向きごと裏返ってしまうという現象が起きてしまいます。
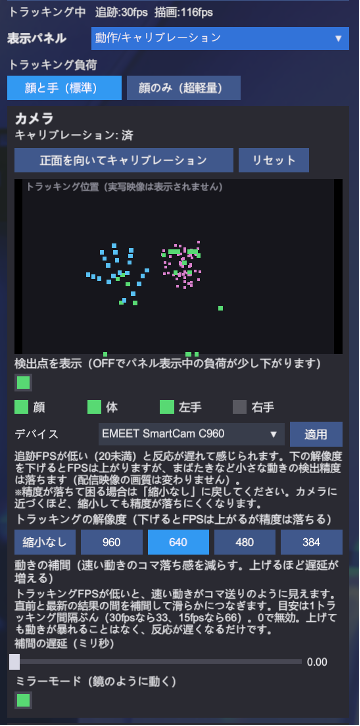
ここは非常に苦労しており、正直なところ、今現在でもまだまだ完全とはいえません。
対処法として、カメラから届いた生データを骨に流す前に、いくつもの処理を重ねています。
- 明らかにおかしい値は、ならす前に取り除く
おかしな値を混ぜたまま平均すると、その影響が長く残ってしまうためです。
- 止まっているときと動いているときで、補正の強さを変える
静止中は揺れを消し、動き出したら補正を緩めて遅れないようにします。「揺れを消す」と「動きに遅れない」を両立するための工夫です。
- 見えていない部分は、測定値ではなく身体の構造から補う
手のひらのように形が決まっている部分は、指に隠れても崩れないようにしています。
- 「どれだけ信じるか」を見え方に応じて連続的に変える
情報を使う・捨てるを急に切り替えると動きが飛んでしまうため、信頼度を滑らかに変化させています。
こうした処理によって、比較的安定した上半身のトラッキングを実現できました。
低スペックのPCでも動くようにCPUやGPUの使用率を下げるための実装も行っており、オプションから簡単に負荷設定を変えることもできるようにしています。
今後は、PCのスペックに応じて部分的にNVIDIAのトラッカーを用いる、iPhoneで深度情報を取得する、VMCでの送受信 、等さらなる拡張も検討中です。
高精度だけではなく、「手軽に使える」ことを大切に
専用機材を使えば、もちろん、より高精度なトラッキングが可能です。
実際に26年7月に行ったオンライン3Dライブ「ゆめみなな生誕祭2026」では、光学式のモーションキャプチャーを使用しました。また、単眼カメラでも、LiDARのようなセンサーを搭載した高精度なトラッキングが可能なものもあります。
ただし、その多くは高価だったり、広いスペースが必要だったり、セットアップの手順が複雑でタレント自身が自宅で使いこなすのには向いていなかったりします。
配信前の準備はできるだけ手軽でなければならず「3D配信は手間がかかるから使いづらい」と思われてしまうのは、非常にもったいないことです。
そのため、マーカーレスで、手軽にすぐ始められることを何よりも重要視しています。
理想は、完全マーカーレスかつセットアップ工数ゼロで、精密な全身モーションキャプチャーを実現すること。
まだ多くの研究や時間が必要ですが、最新の技術動向を追いながら、精度と手軽さの両方を兼ね備えた方法を取り入れていきたいと考えています。
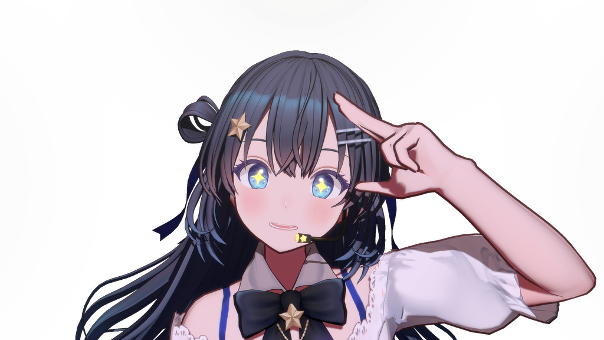
AI VTuber『ゆめみなな』を3Dで動かす仕組み
開発したアプリには、人間のタレントだけではなく、AI VTuberを動かす仕組みも組み込まれています。
AI VTuberは、AI(LLM)側から届く「joy」「sad」といった短い信号を受け取って動きます。
例えば「喜」という信号に10種類の動きを登録しておけば、その中から毎回ランダムに動きを選択します。
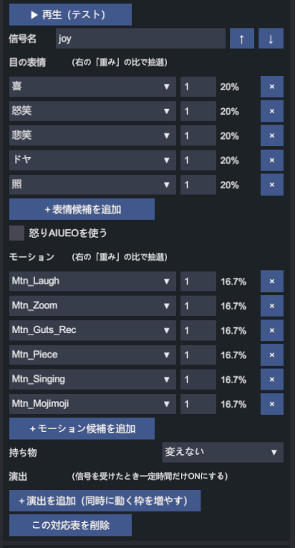
これによって、同じ合図が続いても機械的に見えないようにしています。
また、動いている最中に次の信号が届いた場合は、あえてその信号を捨てることもあります。
すべて順番に再生すると、動きが途中で次々に切り替わって不自然になってしまい、かといって動きを溜めて後からまとめて再生しても、その頃には会話の内容と動きがズレてしまうためです。
実際の人間も短時間に連続してオーバーリアクションをするわけではないため、あえて動きを抑制しています。
照明、カメラ、エフェクトなどの演出信号は、AI VTuberの動きとは別に制御できます。現在は、歌枠で歌った際に演出がONになる仕組みも実装しています。
リップシンクについては、人間と同じようにAIにも「あ・い・う・え・お」を発音してもらってキャリブレーションを行い、破綻しにくい音声シンクを実現しています。
さらにコラボモードでは、話し声を判定し、自動的に相手の方を向いて話を聞くこともできます。
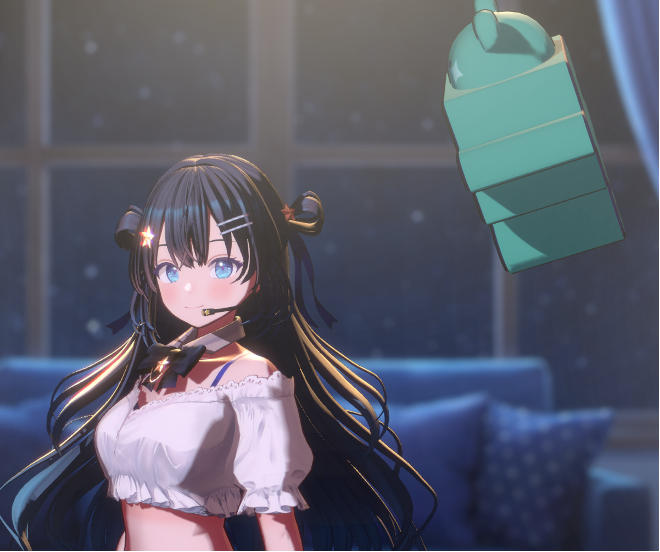
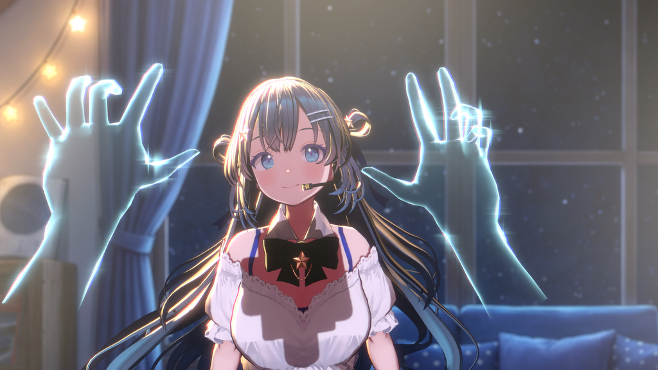
現在配信でお見せできているAI VTuberの動きは、用意しているバリエーションのごく一部です。
今後も、より多彩な表現で、より生き生きと動く『ゆめみなな』を視聴者の皆さんに届けられるよう、開発を進めていきます。
職種の壁を超える新しい開発スタイル
ここまでご紹介した3D配信アプリは、3Dデザイナーである私一人では、とても実装できるような内容ではありませんでした。
さまざまな情報を調べ、先人の知恵を借りながら、エンジニアとの連携やAIも活用して仕上げています。
特にAIVTuberはまだ前例が少ないこともあり、試行錯誤の連続です。配信前には毎回ドタバタ、てんてこまいになりながら開発しています。
表現のアイデアを出す → 試行錯誤する → クリエイターが作った見栄えをそのまま実装して確認する。
AIの発展によって、この試作(プロトタイピング)の流れを個人の手元で素早く回せるようになったことは非常に大きいと感じています。
これまでは、デザイナーがイメージを作っても、実際に動く形にして確認するには企画やエンジニアなど多くの方との丁寧なすり合わせが必要でした。そもそも開発をしようとすると他人の工数を使って進めてよいか。の大前提の話がある為、その時点で行動に移す事は難しく、開発の腰が重くなったりします。
さらに開発に関わる人数が増えるほど、細かい意図やニュアンスを伝える難しさもあり、お互いに試行錯誤のコストがかかる場面も少なくありません。
この点はAIを活用することで、クリエイターは実装された状態を持って会話を開始できるようになり、職種の壁を超えたコミュニケーションがよりスムーズになりました。お互いが使う工数も最小限に抑えつつ、新たな開発をどんどんと行うことが出来ます。
専門職同士がより高い次元でコラボレーションできるようになり、プロダクト開発のスピードとクオリティは今後数年で大きく進歩していくと思われます。
これから、さらに多くの企業や個人が素早い進捗をだしていく中で、どのように差別化をはかり面白いエンターテインメントや価値を提供していくのか。
常にアンテナを張りながら、今後も「ゆめかいろプロダクション」ならではの新しい表現に挑戦していきたいと思います。
田中 典(たなか・つかさ)KLab株式会社 3Dデザイナー。
「ゆめかいろプロダクション」における3Dライブ演出技術の開発を主導。高度なエンジニアリング知識が求められる効率化ツールの開発を、AIを活用することで自ら実現し、大幅なコストと工数の削減を達成した。
このブログについて
KLabの社内や社員の様子、サービスについての情報を発信します。
 広報X
 広報Facebook
おすすめ
合わせて読みたい
このブログについて
KLabの社内や社員の様子、サービスについての情報を発信します。